← 全部题库
QINGYUN QUIZ READER

行测-编程 · 10题

按题库顺序整理 · 可搜索、跳题与自测 · 答案按题库原始状态保留

10完整题目
已整理
⌕

点击选项可自测;点击“隐藏全部答案”后,可逐题展开核对。

QUESTION 1单选 · 4 个选项

1.

关于面向对象设计的原则,以下说法错误的是?(  )

题库标注答案D
D · 重用的粒度应小于发布的粒度
查看题目解析

这是面向对象设计的原则之一,通常表示应该将代码划分为小的可复用的模块或类,以便在需要时可以更容易地重用它们。不应该发布整个大的、复杂的模块或类,而是将其拆分为更小的、独立的部分,以便可以选择性地重用这些部分。其他选项A、B和C是面向对象设计中的其他重要原则,分别是单一职责原则、里氏替换原则和依赖反转原则。这些原则一起构成了面向对象设计的基础。
QUESTION 2单选 · 4 个选项

2.

编写SQL代码时,如果进行以下代码实现:(  )

SELECT * FROM tb_user

UNION

SELECT*

FROM

TB_DEPT

那么结果为:

题库标注答案B
B · 将tb_user与tb_dept两个数据表数据并集
查看题目解析

SQL代码中的UNION操作用于将两个查询的结果合并成一个结果集,去除重复的行。根据提供的代码:

SELECT * FROM tb_user

UNION

SELECT * FROM tb_dept

正确答案是:

B将tb_user与tb_dept两个数据表数据并集

这个代码将tb_user和tb_dept两个表的所有数据行合并成一个结果集,去除了重复的行。不需要数据行数相同,也不需要tb_user的数据行数大于tb_dept表中的数据行数。只要它们的列匹配,就可以合并结果。

QUESTION 3多选 · 4 个选项

3.

决策树有哪些常用的启发函数(  )

题库标注答案B、C、D
B · 最大信息增益率
C · 最大基尼系数
D · 最大信息增益
查看题目解析

决策树在构建过程中通常使用以下启发函数:

B最大信息增益率

C最大基尼系数

D最大信息增益

所以正确答案是 B、C、D。最大交叉熵不是常用的决策树启发函数。

QUESTION 4多选 · 4 个选项

4.

以下关于集成方法Boosting和Bagging的描述确的是(  )。

题库标注答案A、B
A · Bagging方法中每次只用训练集的一部分训练模型
B · Bagging方法适合按照顺序训练模型
查看题目解析

正确的描述是:

A.Bagging方法中每次只用训练集的一部分训练模型。

B.Bagging方法适合按照顺序训练模型。

所以正确答案是 A 和 B。Bagging方法通过有放回地随机抽样训练集的子集,然后并行训练多个模型,最后将它们的结果组合以获得更稳定的模型。而Boosting方法则是逐步训练一系列模型,每个模型都会根据前一个模型的性能进行调整,因此每次模型的训练数据集都会变化。Boosting方法通常不适合并行化。

QUESTION 5多选 · 4 个选项

5.

以下关于决策树的描述正确的是(  )。

题库标注答案B、C、D
B · 决策树上决策节点对应着属性
C · 决策树剪枝的主要目的是防治过拟合
D · C4.5和CART是典型的决策树算法
查看题目解析

正确的描述是:

B决策树上决策节点对应着属性。

DC4.5和CART是典型的决策树算法。

所以正确答案是 B 和 D。决策树的决策节点对应于属性,每个节点都表示对某个属性的测试或决策。C4.5和CART是两种常见的决策树算法。

QUESTION 6单选 · 4 个选项

6.

统计中,通常用样本参数推测总体参数,而要提高推测的精度,需要(  )。

题库标注答案A
A · 在置信水平不变时,增加样本数量
查看题目解析

为了提高推测的精度,通常需要:

A在置信水平不变时,增加样本数量。

增加样本数量可以减小抽样误差,提高参数估计的精度。选项 A 是正确的答案。

QUESTION 7多选 · 4 个选项

7.

隐马尔可夫模型三个基本问题以及相应的算法说法正确的是(  )

题库标注答案B、C、D
B · 评估一前向后向算法
C · 学习一Baum-Welch算法
D · 解码一维特比算法
查看题目解析

隐马尔可夫模型(HMM)涉及三个基本问题,以及相应的算法如下:

学习问题(Learning Problem):给定观测序列,目标是学习模型的参数,使其能够最好地匹配观测序列。常用的算法是 Baum-Welch 算法,也称为期望最大化(Expectation-Maximization,EM)算法,用于参数估计。

评估问题(Evaluation Problem):给定观测序列和模型参数,目标是计算观测序列的概率。前向算法用于解决这个问题。

解码问题(Decoding Problem):给定观测序列和模型参数,目标是找到最可能的隐藏状态序列。维特比算法通常用于解决这个问题。

正确答案是:

A学习问题一Baum-Welch算法

B评估问题一前向算法

D解码问题一维特比算法

QUESTION 8主观题 · 0 个选项

8.

题干:

输入n个字符申,将输入的字符审按照字母顺序进行排序。如果第一个字符相同,则从第二个字符开始按字母顺序排序,依次类推。

测试示例:

输入:

state

gas

matter

liquid

solid

输出:

gas

liquid

matter

solid

state

问题:根据要求完成编码,提供main函数,要求考虑编码可读性、性能。

本题为主观题或说明页,题库未提供选项。
题库标注答案未提供
题库未提供标注答案
题库未提供题目解析
QUESTION 9主观题 · 0 个选项

9.

题干:

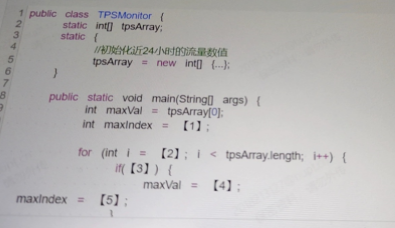
系统每1小时统计并记录一次流量网站流量,请设计最优算法。找出24小时内,流量最大的是哪个小时。并打印流量峰值?

问题:

请补全下面程序的【】处,以实现该功能。答题后不得将【】框删除。

ixunke-parser-media

本题为主观题或说明页,题库未提供选项。
题库标注答案未提供
题库未提供标注答案
题库未提供题目解析
QUESTION 10主观题 · 0 个选项

10.

题干:

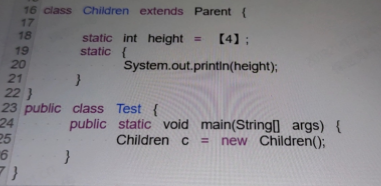
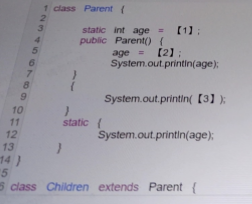
一个类从被夹在到虚拟机内存中开始,到卸载出内存为止,它的整个生命周期将会经历多个阶段,创建对象是其中比较重要的阶段。

问题:

请补全下面程序的【】处,以实现依次输出30、60、50、40。答题后不得将【】框删除。

ixunke-parser-media

ixunke-parser-media

本题为主观题或说明页,题库未提供选项。
题库标注答案未提供
题库未提供标注答案
题库未提供题目解析